ローカル AI アプリの開発

RTX ノート PC、デスクトップ、RTX PRO ワークステーションから DGX Spark や Station AI スーパーコンピューターに至るまで、NVIDIA GPU 上でローカルで構築および実行を行い、高速かつプライベートで、無制限の AI を実現します。 CUDA を搭載した NVIDIA GPU は、主要なすべての AI フレームワーク、オープンウェイト モデル、エージェントを高速化し、開発者がこれまで以上に迅速に AI の実験、構築、デプロイを行うことができます。

利点

NVIDIA GPU を使用してローカル AI を構築および実行する理由とは?

装飾イメージ

最も広範なエコシステム

CUDA ライブラリ、オープンソースフレームワーク、SDK、モデルに至るまで、AI スタックのあらゆる層が NVIDIA 上で最適化されており、広大なコミュニティと ISV (独立系ソフトウェア ベンダー) のサポートを備えています。

装飾イメージ

採用しやすいツール

NVIDIA とオープンソース コミュニティは、ComfyUI、Hermes、llama.cpp、Ollama、ONNX、OpenClaw、PyTorch、vLLM などの人気のある AI ツールを最適化するために緊密に協力しています。 これらのツールは、NVIDIA ローカル GPU とクラウド GPU 全体で同じ CUDA スタックで簡単にインストールでき、実行できます。

装飾イメージ

最新モデルを初日からサポート

LLM から画像生成モデルまで、NVIDIA とモデル ラボの緊密な連携により、新しいオープンソース モデルは NVIDIA GPU 上で初日から高速に実行されます。

装飾イメージ

最大のインストールベースと統合開発スタック

1.5 億台を超えるローカル NVIDIA GPU の稼働基盤。 一度開発すれば、PC およびクラウド上の NVIDIA GPU にデプロイできます。

装飾イメージ

パフォーマンス

専用の Tensor コアは、継続的に最適化されるフレームワークと NVFP4 チェックポイントとともに、AI ワークロードを高速化します。

ローカル AI アプリの構築方法

装飾アイコン

カスタム モデルの構築と最適化

高度なファインチューニング、量子化、スパース性、蒸留技術を使用して、カスタム モデルを最適化および構築します。

詳細を見る

装飾アイコン

NVIDIA SDK を使用してアプリケーションに AI 機能を追加する

NVIDIA アクセラレーテッド SDK を使用して、3D、生成 AI、ビデオ機能を追加します。

詳細を見る

装飾アイコン

既製の AI モデルを使用する

Ollama、llama.cpp、TensorRT、SGLang、vLLM、WindowsML、または CUDA を備えた PyTorch などの高速化されたランタイムでモデルを実行します。

詳細を見る

AI アプリケーションを最適化して最高のパフォーマンスを引き出すツール

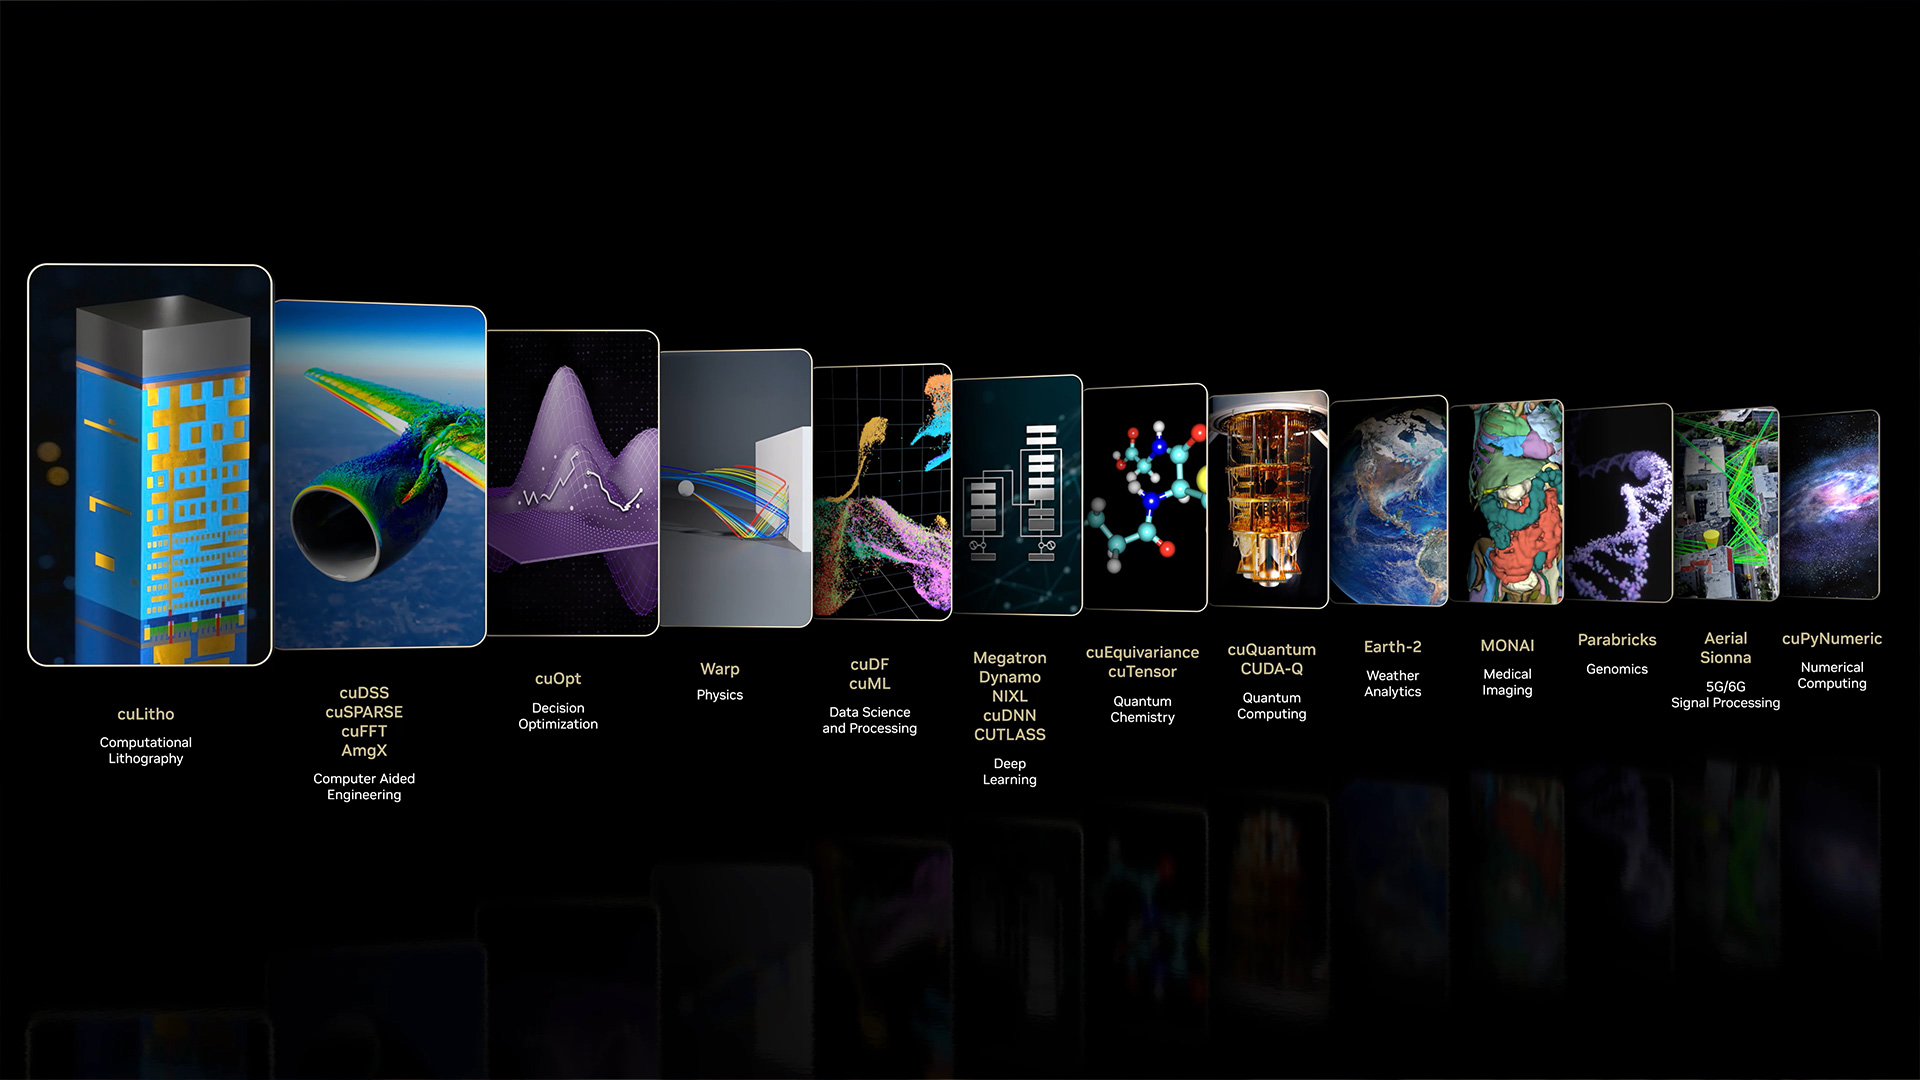
400 以上の CUDA-X™ ライブラリを使用して GPU の性能を最大限に引き出し、NVIDIA Nsight ツールで GPU アクセラレーテッド アプリケーションの構築、プロファイリング、最適化を行います。

CUDA-X を見る


既製の AI モデルを使用する

モデルを選択し、推論バックエンドを選びます。

推論バックエンドにアクセスする

ステップ 1: ローカル AI のユースケースに最適なモデルを選択する

1. 目標とする VRAM とパフォーマンス要件を決定します​
2. 候補の絞り込み:​

推奨レシピを確認するか、公開ベンチマーク (例: Artificial Analysis Index) に基づいて候補を絞り込みます​

  • llama.cpp を使用する場合: 品質を維持しながら最高のパフォーマンスを得るために、Q4_K_M 量子化チェックポイントを優先します​

  • vLLM または PyTorch を使用する場合: 品質を維持しながら最高のパフォーマンスを得るために、NVFP4 量子化チェックポイントを優先します​

3. 評価:

  • ユースケース向けのカスタム評価データセットを構築します​

  • 人間の評価 (Human Evaluation) でモデルを評価します​

  • LLM の場合、LLM-as-a-judge を使用してモデルを大規模に評価します

ステップ 2: ユースケースに最適な推論バックエンドを選択する

開発者は、アプリケーションのデプロイ パスを選択する前に、いくつかの要因を考慮する必要があります。それぞれの推論パスには、特定のモデル最適化ツールとデプロイ メカニズムが用意されています。
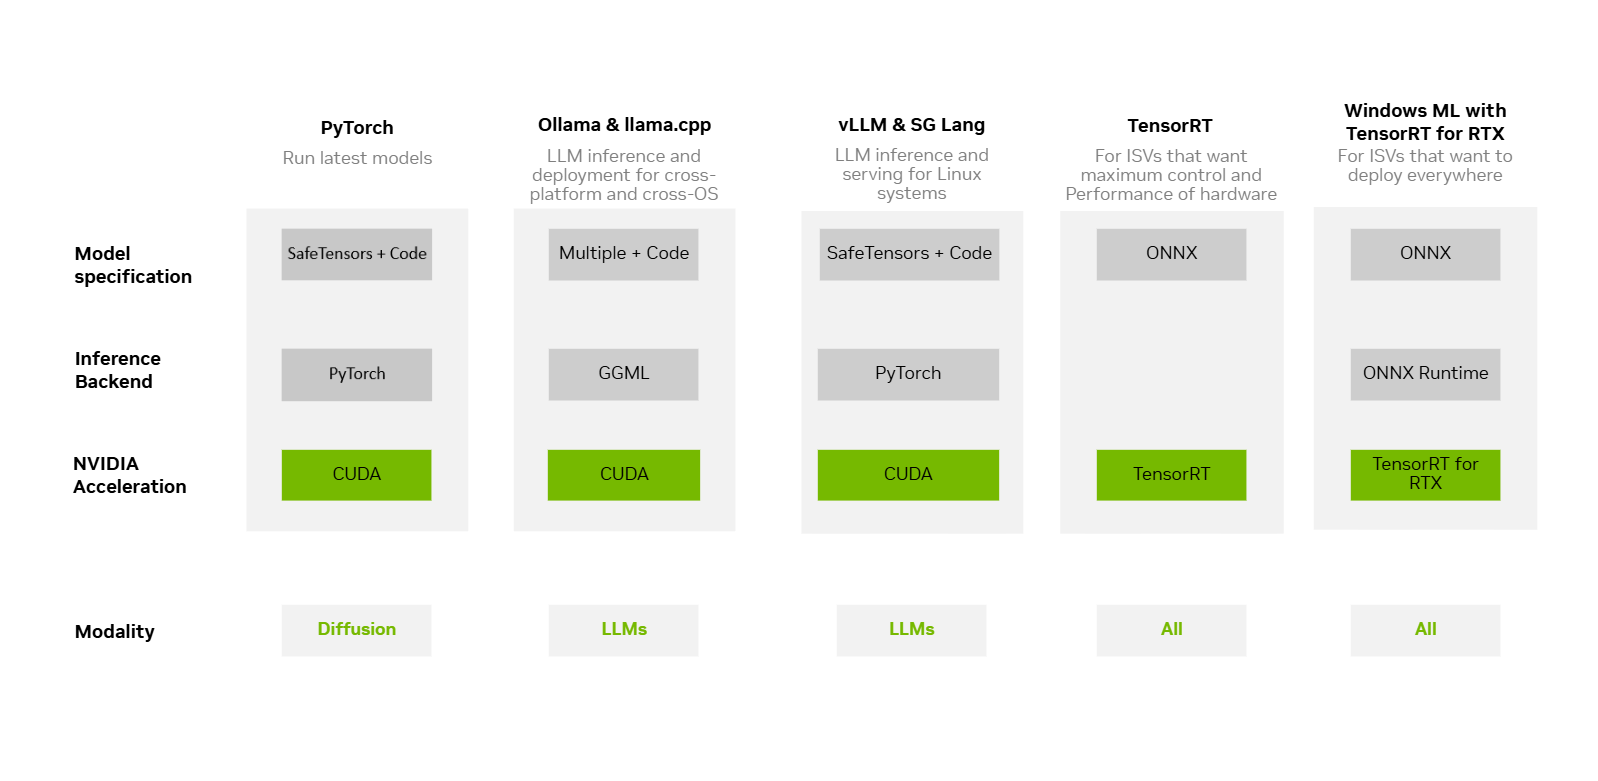
推論バックエンドのオプションを見る

お使いのローカル AI ハードウェア向けに最適化されたレシピを使用する

ローカル AI モデルを選択するための決定フローチャート: VRAM 要件、NVFP4 と Q4_K_M の量子化の選択、ベンチマークによる絞り込み、および LLM-as-a-judge による評価ステップ

(クリックして図を拡大)


NVIDIA SDK を使用してアプリケーションに AI 機能を追加する

NVIDIA SDK を使用すると、事前に最適化およびパッケージ化された AI 機能をアプリケーションに直接追加できます。エージェントが NVIDIA SDK やツールを効果的に活用して GPU アクセラレーテッド アプリケーションを作成できるように支援するポータブルな命令セットである NVIDIA Skills を使用することで、エージェントを活用してあらゆる NVIDIA SDK による開発を進めることができます。

NVIDIA Skills の詳細を見る

NVIDIA DLSS でパフォーマンスを大幅に向上

NVIDIA DLSS

AI を使用してパフォーマンスを何倍にも引き上げるニューラル グラフィックス。新しいフレームの生成、画像の再構築、レイトレーシング コンテンツの向上を実現します。

DLSS の詳細を見る
NVIDIA OptiX による最適なレイトレーシング

NVIDIA OptiX

GPU 上で最適なレイトレーシング パフォーマンスを実現するアプリケーション フレームワーク。

OptiX の詳細を見る
NVIDIA RTX Kit によるニューラル レンダリング

NVIDIA RTX Kit

ニューラル レンダリング テクノロジのスイート。

RTX Kit の詳細を見る
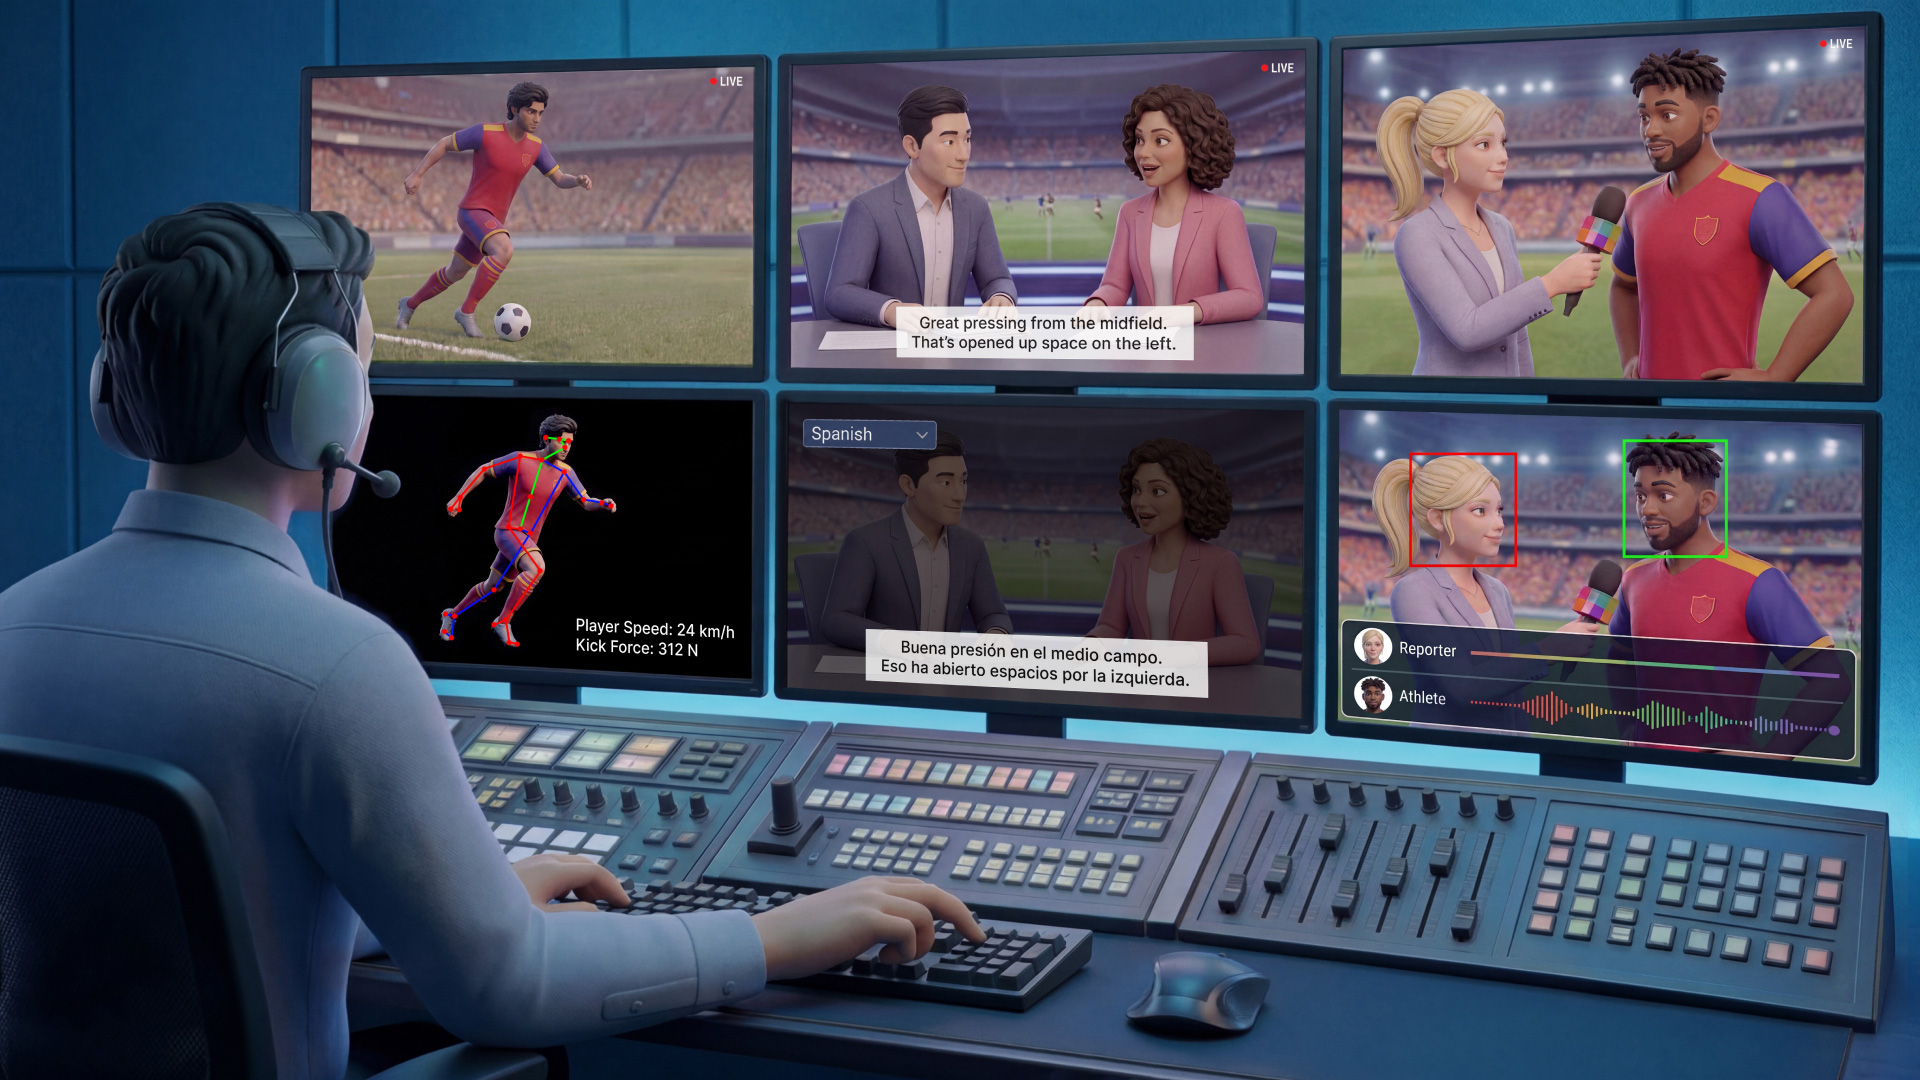
RTX ハードウェア上のビデオ会議およびテレプレゼンス アプリケーション向けの、AI 強化オーディオ、ビデオ、AR エフェクトを示す NVIDIA AI4M インターフェース

NVIDIA ACE

ゲーム向けのデジタル ヒューマン テクノロジ スイート。

ACE の詳細を見る
RTX ハードウェア上のビデオ会議およびテレプレゼンス アプリケーション向けの、AI 強化オーディオ、ビデオ、AR エフェクトを示す NVIDIA AI4M インターフェース

NVIDIA AI for Media

ビデオ会議およびテレプレゼンス向けの AI により強化された音声、動画、AR エフェクト。

AI for Media の詳細を見る
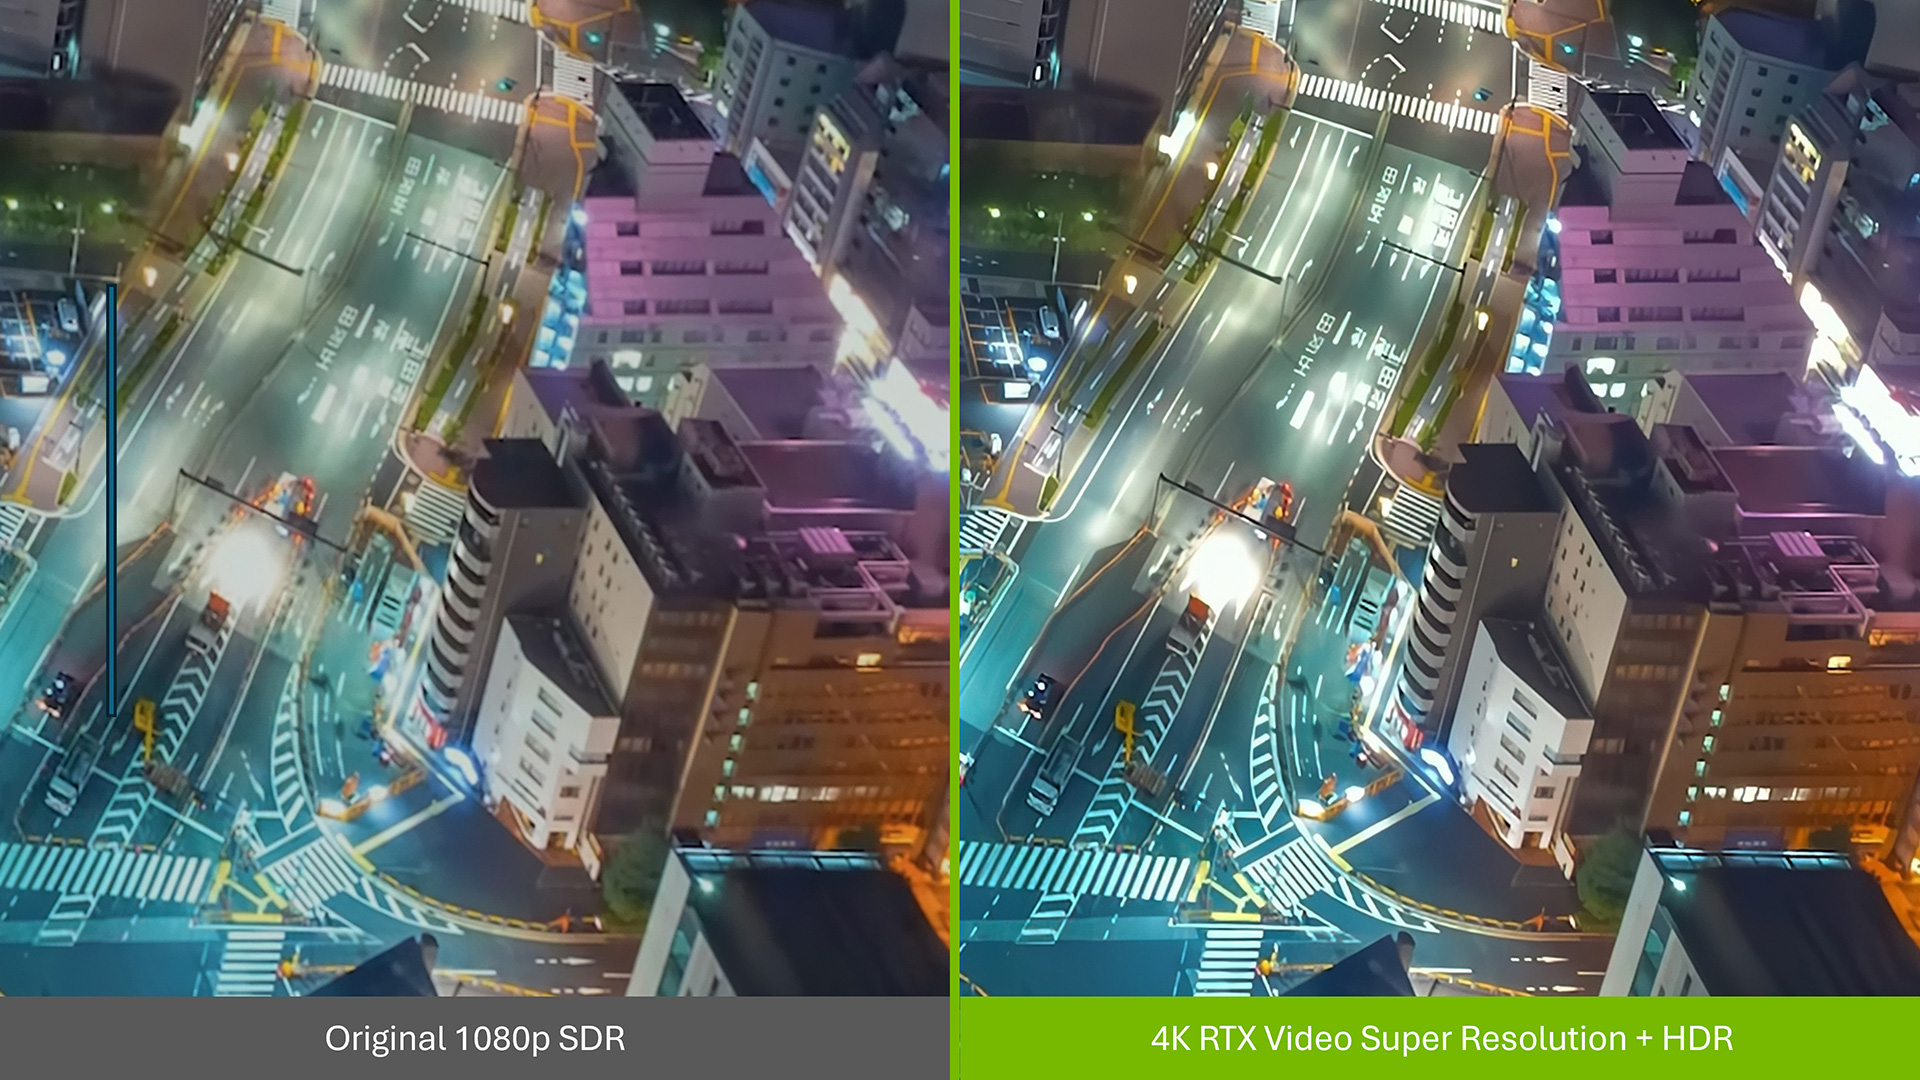
RTX 搭載ディスプレイでのアップスケールされたビデオ再生を示す NVIDIA RTX Video AI 超解像および HDR 強化インターフェイス

RTX Video

クリエイティブおよびメディア再生アプリ向けの AI 強化超解像と HDR エフェクト。

RTX Video の詳細を見る
NVIDIA GPU ベースのビデオ処理パイプライン向けのハードウェア アクセラレーテッド エンコードおよびデコード API を示す NVIDIA Video Codec SDK アーキテクチャ図

Video Codec SDK

主要なコーデック全体で NVIDIA GPU によるハードウェア アクセラレーテッド ビデオ エンコードおよびデコードを行うための包括的な API、ツール、サンプル。

Video Codec SDK の詳細を見る
NVIDIA Omniverse によるフィジカル AI シミュレーション

NVIDIA Omniverse

フィジカル AI シミュレーションおよびエージェント ワークフロー向けのアクセラレーテッド ライブラリ、マイクロサービス、スキル。

Omniverse の詳細を見る
ミキサー、空のグラス、別のマグカップが置かれたキッチン カウンターの後ろで、白いマグカップを持つ人型ロボット。

ロボティクス

NVIDIA のオープン モデル、フレームワーク、ライブラリを使用して、よりスマートで安全なロボットを構築します。

ロボティクスの詳細を見る
Illustration of a processor chip surrounded by streams of colorful icons representing text, images, and data against a black background.

クラウドにおける生成 AI

生成 AI は、ニューラル ネットワークを使用して既存のデータからパターンを学習し、新しい独自のテキスト、画像、音声、ビデオ コンテンツを生成する人工知能の一種です。

OptiX の詳細を見る
屋根にセンサーを搭載した黒と緑の NVIDIA 自動運転テスト車両。カメラ フィード、道路マッピング、センサー カバレッジの可視化に囲まれています。

自動運転車

NVIDIA は、センサー データのキュレーションや合成データ生成から、モデル トレーニング、クローズドループ シミュレーション、本番グレードの車載コンピュートに至るまで、自動運転車開発向けのエンドツーエンドのスタックを提供します。

自動運転車の詳細を見る
眼鏡と革ジャンを身につけたトイ ジェンスン フアンが、緑の糸、布、3D プリンターで満たされた作業場で赤いロブスターのぬいぐるみを縫っている様子。

エージェントをローカルで実行するための安全でセキュアなランタイム

NVIDIA OpenShell は AI エージェントに安全なランタイムを提供します。OpenShell はサンドボックス化された実行環境とポリシー適用を提供し、エージェントの動作を統制します。

OpenShell の詳細を見る
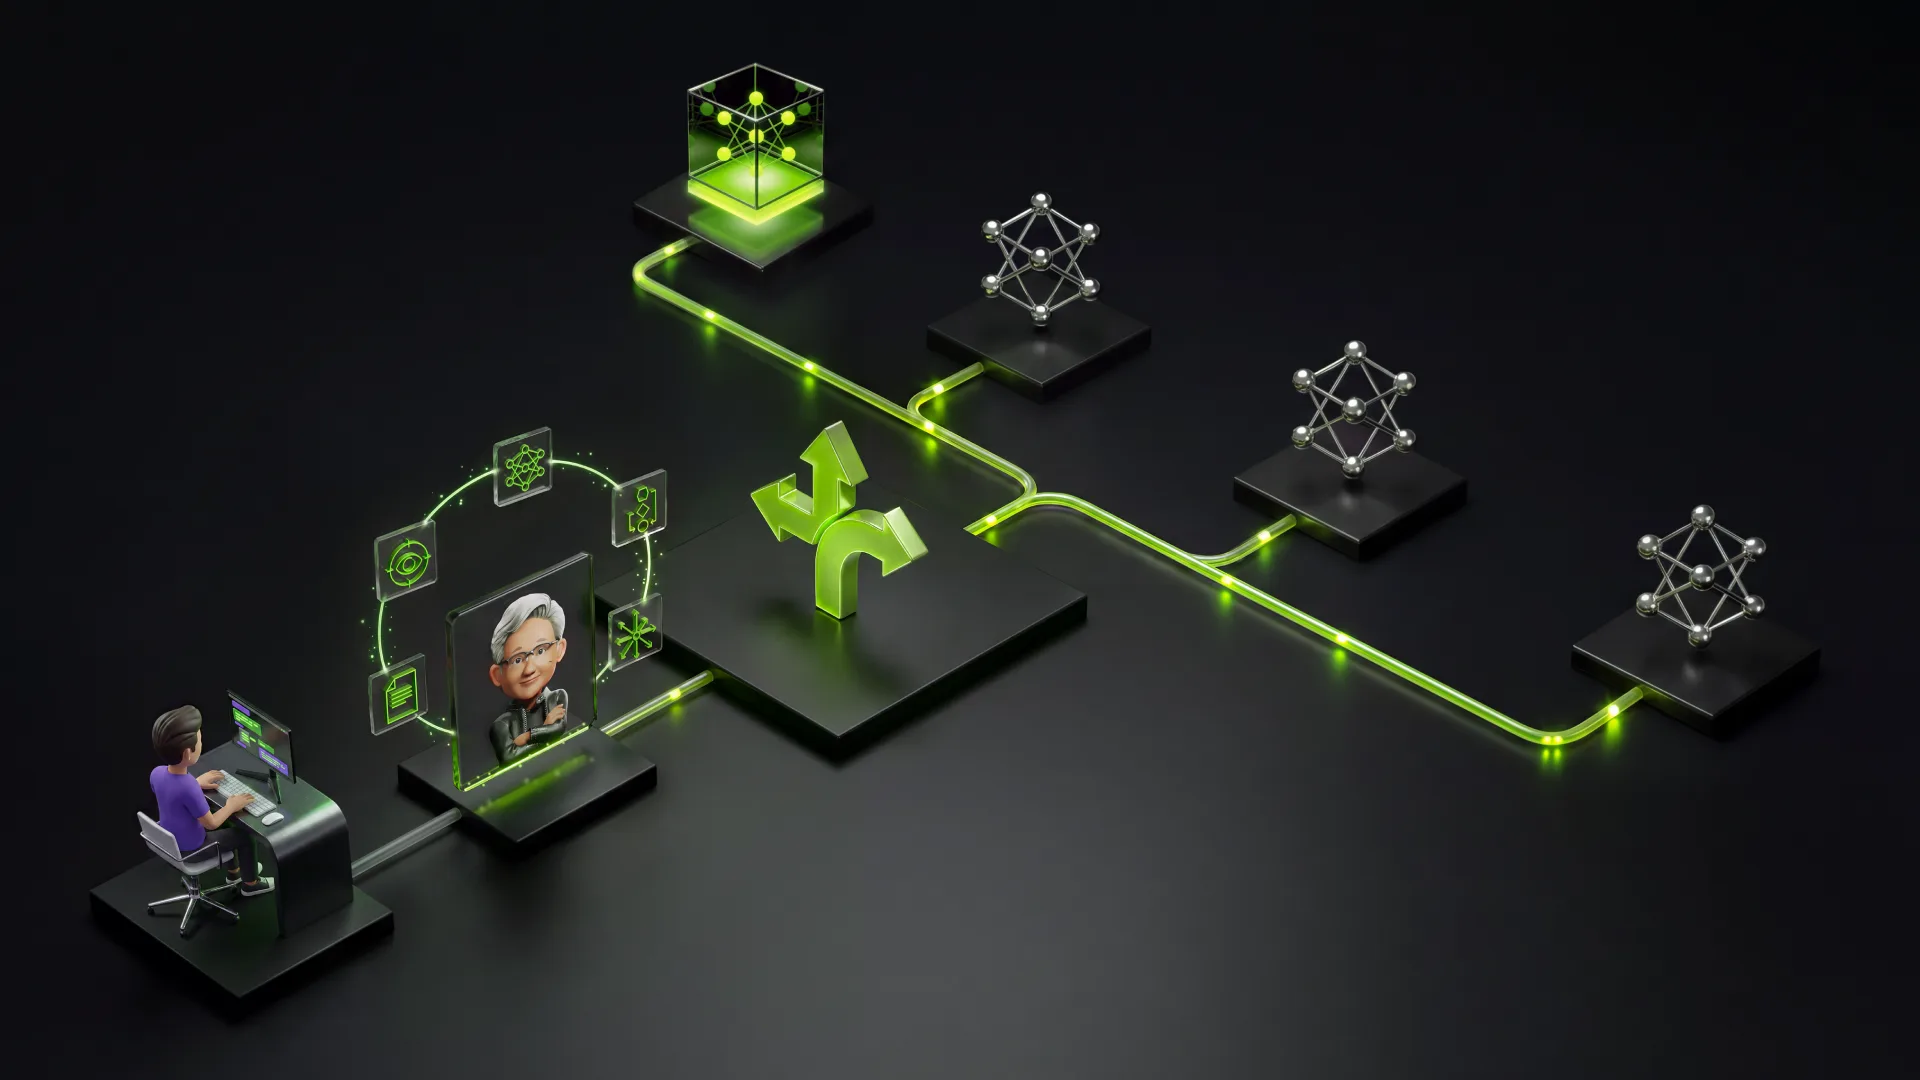
Illustration of中央のルーティング ハブと光る緑のパスを通じて、コンピューター ユーザーとトイ ジェンスン フアンのアシスタントをローカルおよびクラウドの AI モデルに接続するハイブリッド AI ワークフローのイラスト。 a hybrid AI workflow connecting a computer user and Toy Jensen Huang assistant to local and cloud AI models through a central routing hub and glowing green paths.

最適な体験のためにローカルとクラウドにまたがるハイブリッド AI をデプロイ

NVIDIA NeMo Switchyard を使用して、各 LLM の呼び出しをタスクを実行できる最も低コストなモデルにルーティングします。

NVIDIA NeMo Switchyard の詳細を見る
眼鏡と黒の革ジャンを着用し、手の代わりに大きな赤いロブスターのハサミをつけたトイ ジェンスン フアンが、暗い背景に向かって片方のハサミを上げている様子。

エンタープライズ グレードのエージェントを実行するためのブループリント

NVIDIA NemoClaw は、自律型エージェントを構築するためのオープンなブループリント集です。実際のワークフロー全体で推論、計画、行動を行う、ドメイン特化型の常時稼働 AI システムを実現します。

NemoClaw の詳細を見る

カスタム モデルの構築と最適化

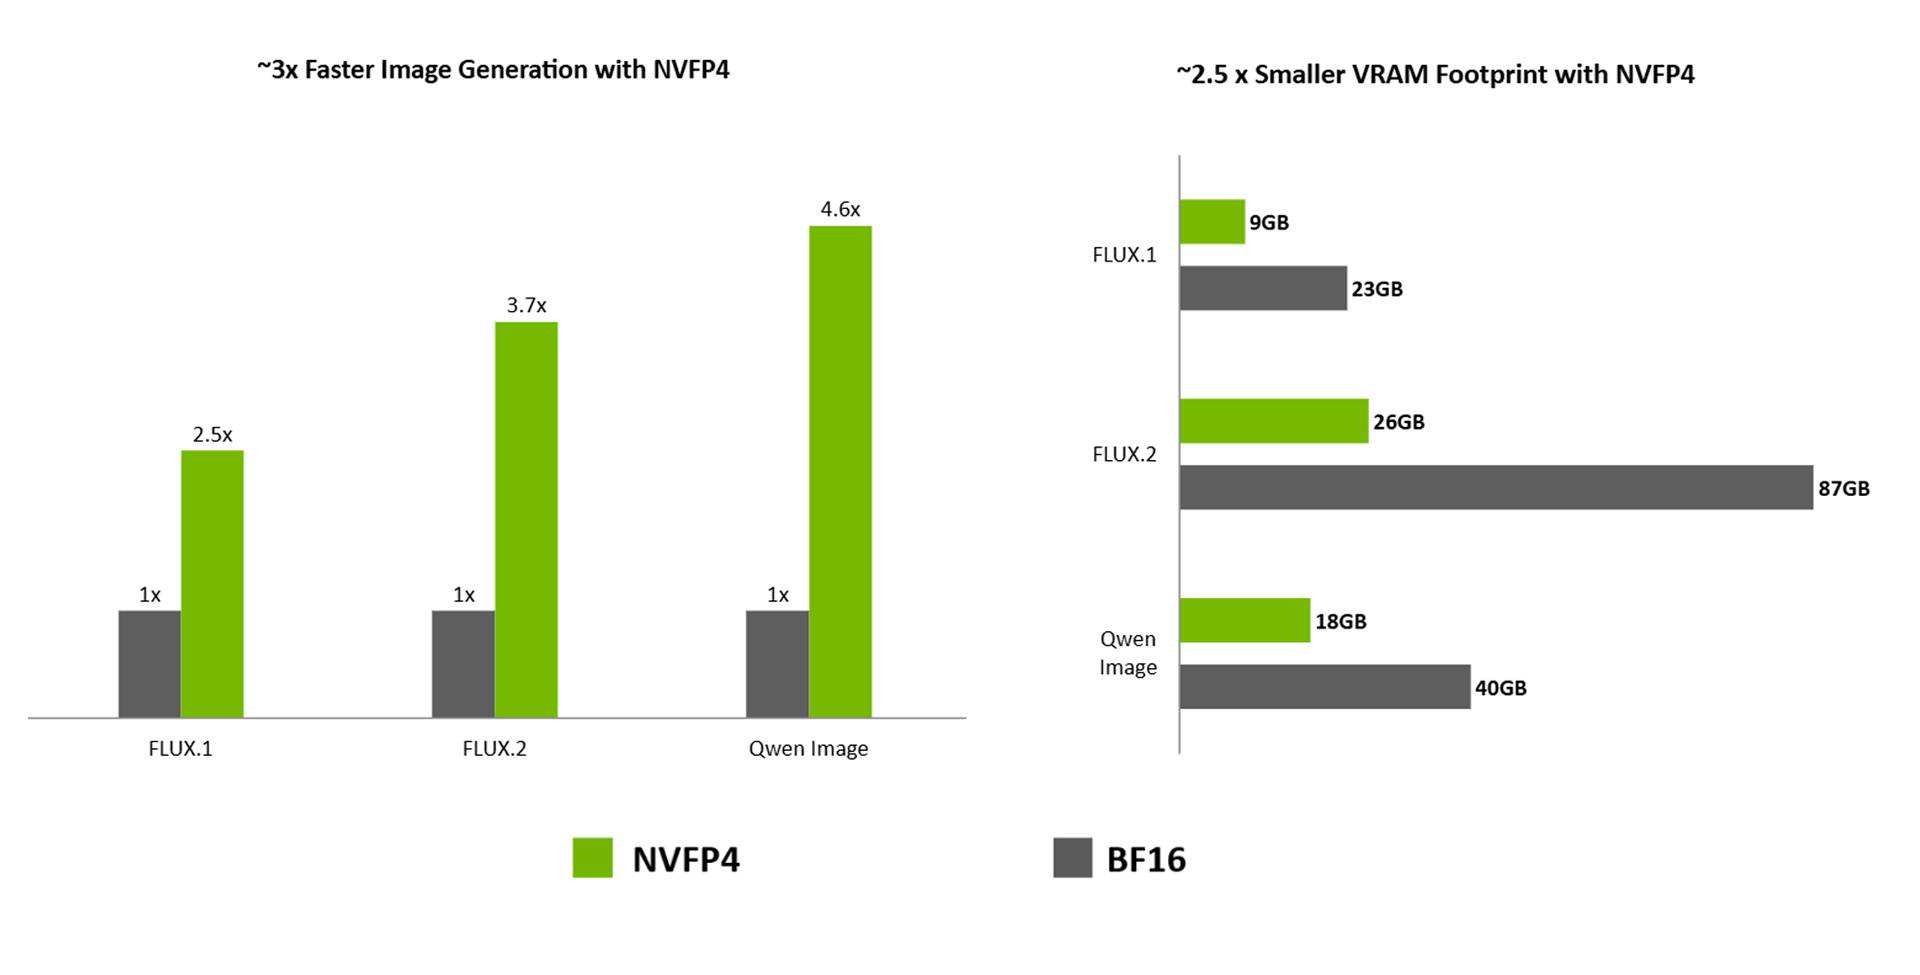
NVIDIA とコミュニティは、あらゆるオープンソース モデルをローカルの NVIDIA GPU 向けに最適化しています。

FLUX.1、FLUX.2、Qwen Image における NVFP4 と BF16 の VRAM 比較。VRAM は低いほど優れています。

(クリックして図を拡大)
モデル チェックポイントの DIY 最適化

NVIDIA Model Optimizer は、量子化、プルーニング、蒸留、投機的デコードなどの SOTA モデル最適化手法を統合したライブラリです。ダウンストリームのデプロイ フレームワーク向けにディープラーニング モデルを圧縮し、推論速度を最適化します。

さまざまな手法について詳細を見る

今すぐ Model Optimizer を使ってみる

最適化されたチェックポイントを推論エンジンにデプロイする

ユースケースに合わせてモデルをカスタマイズする

ローカル AI ハードウェア上で Unsloth を使用してモデルをファインチューニングし、データやユースケースに適応させます。トレーニング データの制御を維持しながら、特殊なタスクでの精度の向上、ドメインに合わせた応答の調整、アプリケーションのスタイルや形式に合わせた出力の成形を実現します。

Unsloth を使ってみる

アプリケーションを最適化して最高のパフォーマンスを引き出すツール

CUDA-X ライブラリと NVIDIA Nsight ツールを使用して、GPU アクセラレーテッド AI アプリケーションの構築、プロファイリング、デバッグ、最適化を行います。

AI 推論およびハイパフォーマンス コンピューティング向けの 400 以上の GPU アクセラレーテッド コンピューティング ライブラリを示す NVIDIA CUDA-X ライブラリ エコシステム

CUDA-X ライブラリ

AI およびハイパフォーマンス コンピューティングのユースケース全体で、業界をリードする GPU アクセラレーションを提供するように設計されたライブラリ スイート。CPU のみの代替手段を大幅に上回る、高度に最適化された複雑なアルゴリズムの実装を提供します。また、AI エージェントの機能を拡張するポータブルな命令セットおよびスキルとしても利用可能です。

CUDA-X ライブラリの詳細を見る

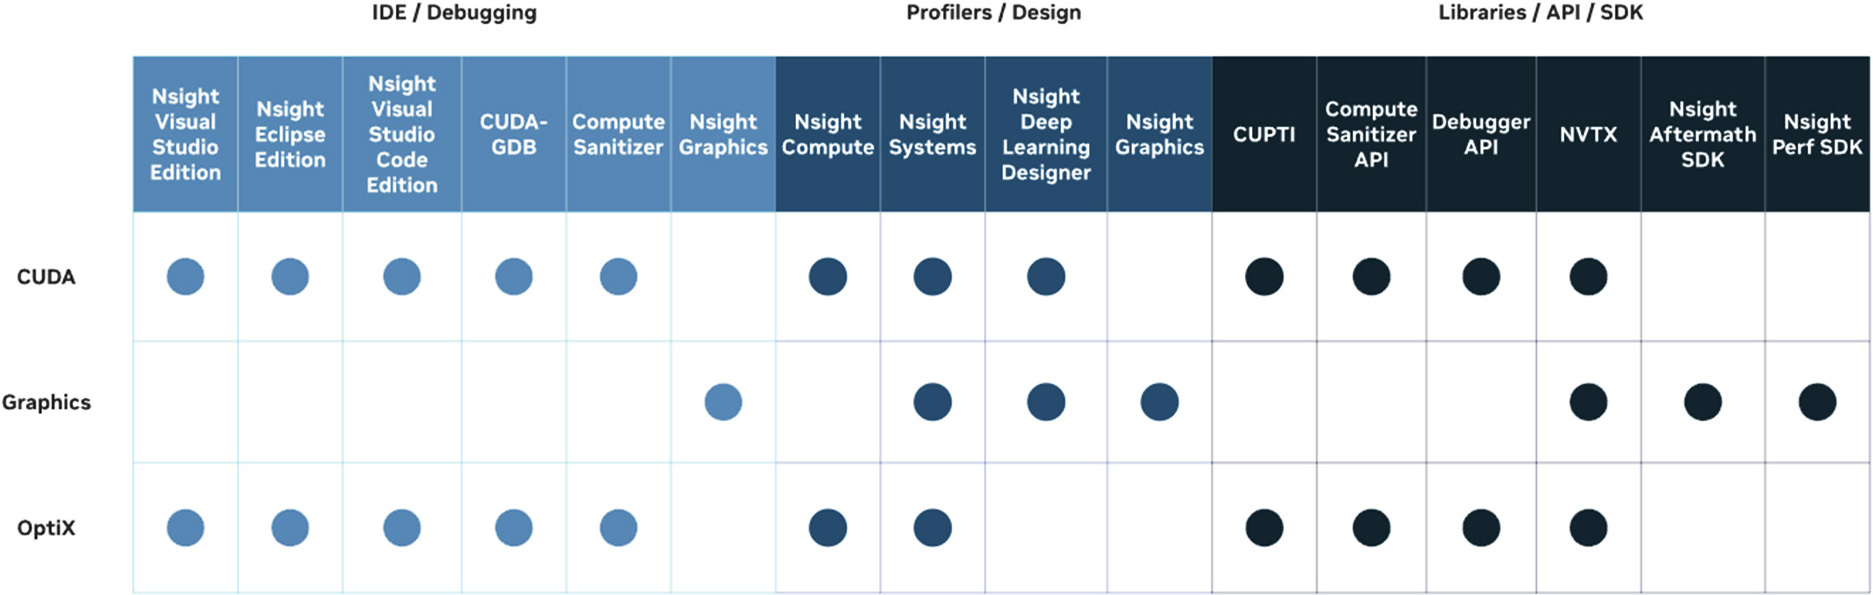
NVIDIA Nsight ツール

最新のアクセラレーテッド コンピューティング ハードウェアを活用するソフトウェアを構築、デバッグ、プロファイリング、開発するためのライブラリ、SDK、開発者ツールのセット。

Nsight 開発者ツールを使ってみる
ローカル AI アプリケーションの GPU パフォーマンス プロファイリング データ、カーネル タイムライン、メモリ使用率を表示する NVIDIA Nsight 開発者ツール インターフェイス

(クリックして図を拡大)

ローカル AI にはどの NVIDIA GPU を使用すべきか?

詳細については、オペレーティング システム、利用可能な GPU またはユニファイド メモリ、モデル サイズ、ワークフローに基づいてハードウェアを選択してください。NVIDIA DGX Spark™ でプロトタイプを作成し、GeForce RTX™、NVIDIA RTX Spark™、または NVIDIA RTX PRO™ で AI およびエージェント ワークフローを実行し、より大規模なローカル モデルや長時間実行されるエージェント向けに NVIDIA DGX Station™ へと拡張できます。

デバイス メモリ OS フォーム ファクター 拡張性 モデル容量
AI 開発を始める方へ

NVIDIA GeForce RTX

最大 32GB の VRAM Windows / Linux ノート PC / デスクトップ 最大 4x 最大 50 B
エンドツーエンドの開発を単一マシンで

NVIDIA RTX Spark

最大 128GB Unified Windows ノート PC / 小型デスクトップ 非対応 最大 120 B

NVIDIA DGX Spark

最大 128GB Unified Linux 小型デスクトップ 最大 4x デバイスあたり最大 200 B
高性能なエージェント型開発

RTX PRO

最大 96GB の VRAM Windows / Linux ノート PC / デスクトップ 最大 4x デバイスあたり最大 150 B
高度なスキルを持つ開発者および開発者チーム

NVIDIA DGX Station
( Windows | Linux)

748 GB Unified Coherent Linux / Windows デスクトップ 最大 2x デバイスあたり最大 1 T
クリエイターおよび開発者向けの NVIDIA RTX Spark コンパクト AI ワークステーション。90GB 以上の 3D シーン、12K ビデオ編集、1,200 億 (120B) パラメータのローカル LLM 推論をサポート

RTX Spark

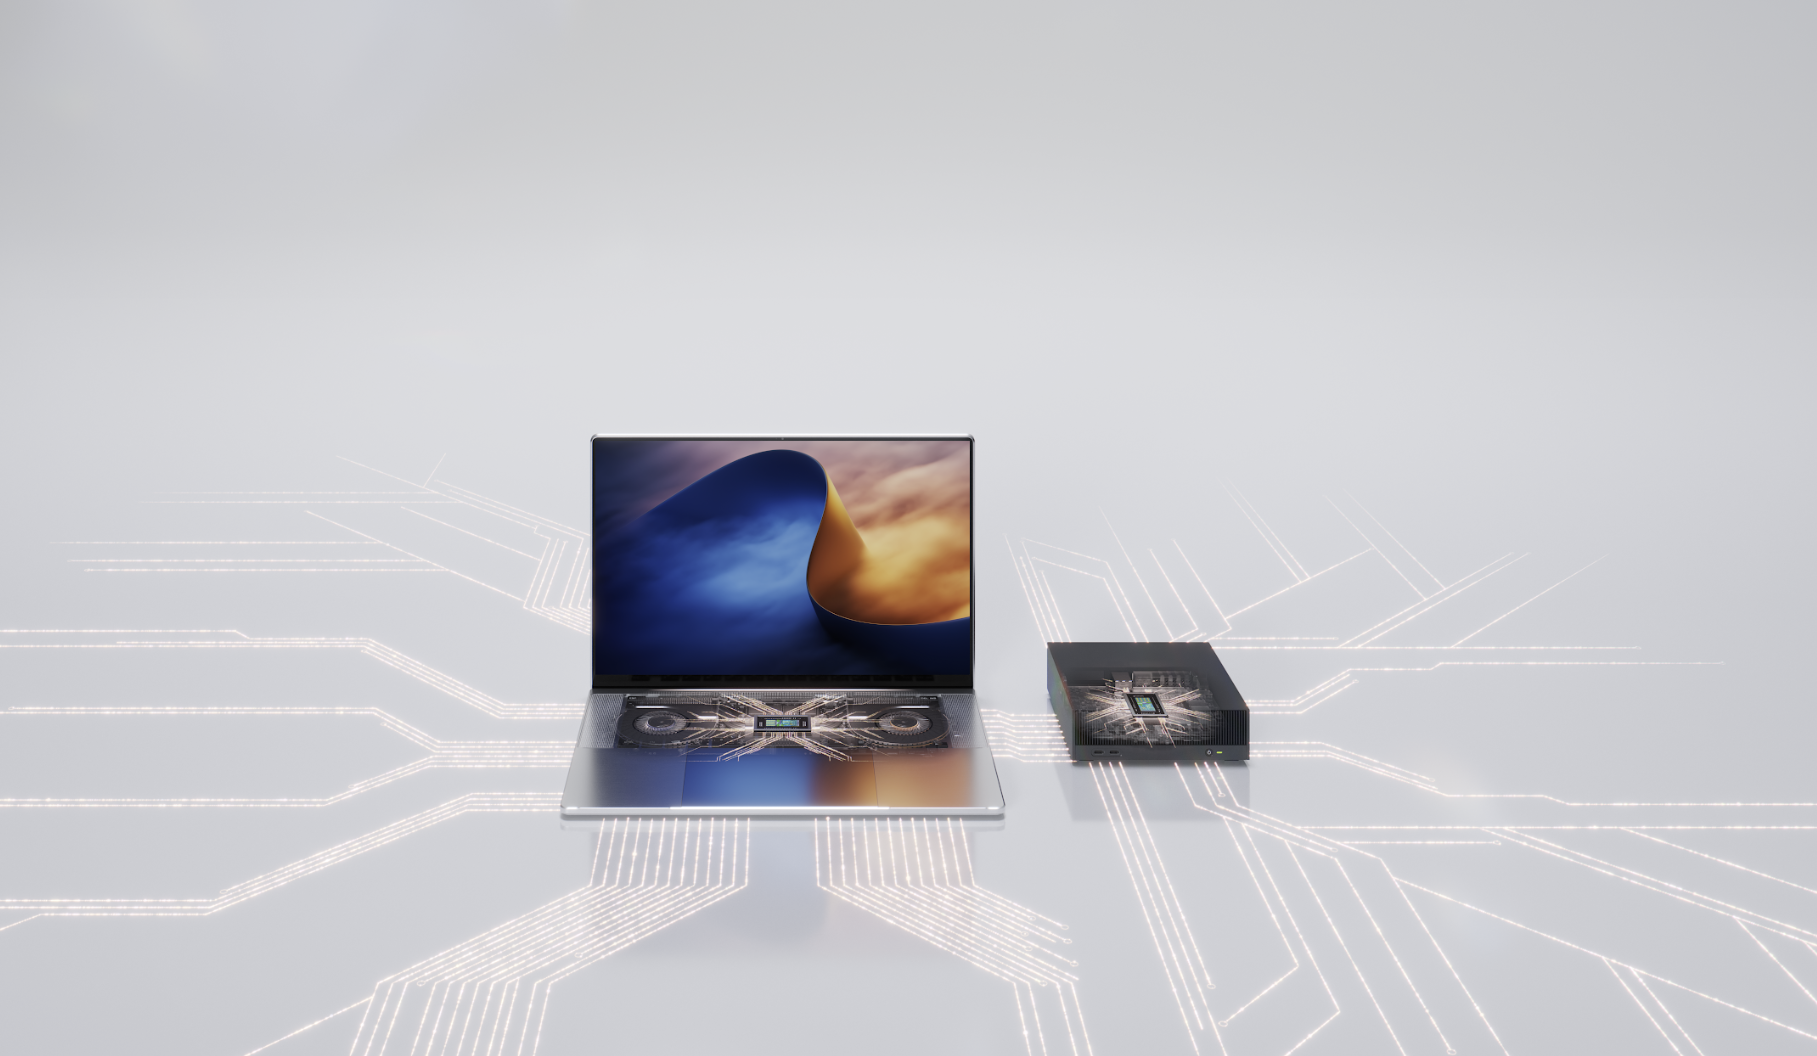
RTX Spark は完全な NVIDIA AI スタックを Windows PC にもたらし、開発者が最大 1,200 億 (120B) パラメータのモデルと 100 万トークンのコンテキストを含む AI モデルやエージェントをローカルで構築、ファインチューニング、実行できるようにします。また、スリムなプレミアム ノート PC やコンパクトなデスクトップ全体で、要求の厳しいクリエイティブおよびゲームのワークロードを高速化します。

GB10 Grace Blackwell Superchip コンパクト デスクサイド システムの前面、背面、側面パネルの図を示す NVIDIA DGX Spark パーソナル AI スーパーコンピューター

DGX Spark

GB10 Grace Blackwell Superchip を搭載したパーソナル AI スーパーコンピューター。FP4 で最大 1 ペタフロップス、128GB のユニファイド メモリ、DGX OS がプリインストールされており、デスク上から最大 700 億 (70B) パラメータのファインチューニングと最大 2,000 億 (200B) パラメータの推論を実行できます。

748GB のコヒーレント メモリと 20 ペタフロップスの FP4 演算性能を備え、最大 1 兆パラメーターの AI モデルをサポートする NVIDIA DGX Station GB300 Grace Blackwell Ultra デスクトップ スーパーコンピューター

DGX Station

最大 748GB のコヒーレント メモリと 20 ペタフロップスの FP4 AI 演算性能を備えた NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip を搭載した NVIDIA DGX Station は、データセンター レベルのパフォーマンスを提供し、最大 1 兆パラメーターの大規模 AI モデルをローカルでサポートします。

NVIDIA GeForce RTX 5090 graphics card for AI-accelerated gaming, creative workloads, and local AI development on a desktop PC

GeForce RTX

RTX AI PC で高度な AI にアップグレードし、ゲーム、制作、生産性、開発を加速します。

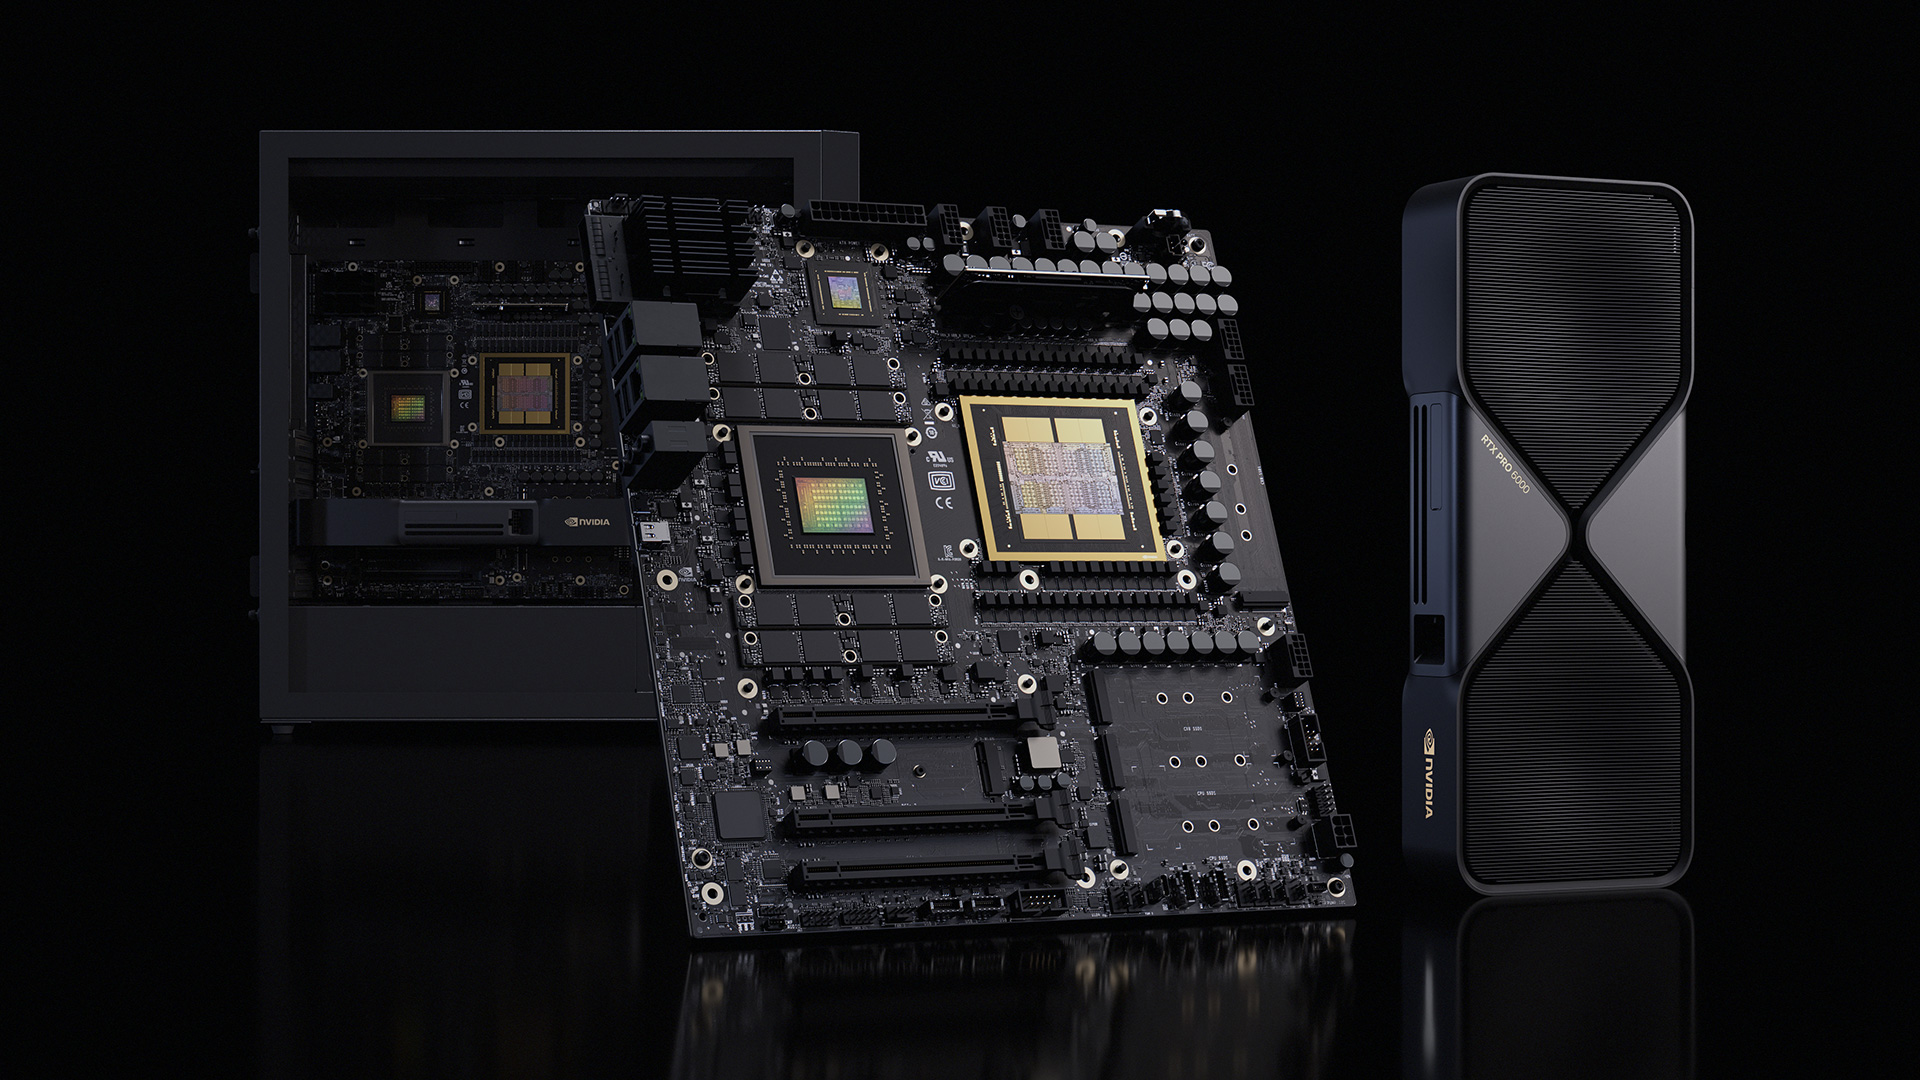
AI 推論、グラフィックス レンダリング、ハイパフォーマンス コンピュート ワークロード向けの NVIDIA RTX PRO Blackwell プロフェッショナル GPU ワークステーション

RTX PRO

NVIDIA RTX PRO Blackwell ワークステーションで、プロフェッショナルな AI、グラフィックス、レンダリング、コンピュートのワークロードを加速します。


NVIDIA GPU で AI 開発を始める

新しいデバイスの導入おめでとうございます。以下の 3 つのステップを確認し、詳細についてはプレイブックにアクセスしてください。

プレイブックを見る

ローカル AI エージェント開発向けの NVIDIA DGX Spark ワークステーションおよび RTX システムのセットアップ。

ステップ 1
Windows システムの開発環境を準備する

注: Linux システムをご使用の場合は、直接ステップ 2 に進んでください

ステップ 2
コーディング エージェントをインストールする

特化型 AI エージェント スキルを表す、プログラマー、教師、医療従事者、建設作業員の服装をした 4 人のトイ ジェンスン フアンのアバターとチャット画面のイラスト。

ステップ 3
エージェントを NVIDIA Skills に接続する


NVIDIA GPU 上でのローカル AI 向け開発ガイド

RTX Spark

アプリケーションをこの新しい Windows on Arm プラットフォームに今すぐ移植して、ユーザーが期待する高速で信頼性の高いネイティブ体験を提供し、NVIDIA RTX Spark 向けプラットフォームを既に採用している 100 社以上のソフトウェア プロバイダーに参加しましょう。

RTX Spark ポーティング ガイド

DGX Spark

DGX Spark は、AI の開発とデプロイに強力なコンピューティング機能を必要とする開発者、データ サイエンティスト、AI 研究者向けに設計された NVIDIA のコンパクトな AI コンピューターです。

NVIDIA DGX Spark 開発ガイド

DGX Station

NVIDIA DGX Station は、大規模な AI ワークロードをローカルで開発および実行するために、最大 748GB のコヒーレント メモリを備えた NVIDIA GB300 Grace Blackwell デスクトップ Superchip 上に構築されたデスクサイド AI コンピューターです。

NVIDIA DGX Station 開発ガイド

ローカル AI 開発者向け関連情報

装飾アイコン

開発者フォーラム

装飾アイコン

ガイドとプレイブック

装飾アイコン

開発者向け Discord サーバーに参加する

NVIDIA 開発者向けの最新ニュースを入手しましょう。

登録する